
dLocal: Cientos de personas creando y consumiendo productos de datos con Databricks, Unity Catalog y Genie

Resumen ejecutivo: Al transformar su arquitectura de datos en un producto de autoservicio con Databricks, Unity Catalog y Genie, dLocal permitió que cientos de colaboradores en 15 dominios de negocio crearan y consumieran de forma independiente productos de datos certificados. Así redujo el tiempo entre una pregunta y su respuesta de días a minutos e impulsó la adopción de datos en toda la compañía.
El desafío: construir una base de datos para la próxima etapa de escala
dLocal procesa pagos en más de 60 mercados emergentes para algunos de los comercios globales más grandes del mundo. A medida que la compañía crecía y gestionaba miles de millones de transacciones al año en América Latina, África y Asia, el volumen, la complejidad y la importancia estratégica de sus datos crecieron al mismo ritmo.
Con esa escala, el modelo de datos que había acompañado su crecimiento necesitaba evolucionar. Métricas clave como transacciones, ganancia bruta y tasas de conversión estaban definidas en más de un lugar, y un equipo central de datos concentraba la mayor parte de la ingesta, la transformación y los reportes, lo que dificultaba sostener la consistencia en una cantidad creciente de dominios.
Además, contar con definiciones consistentes y gobernanza a escala era fundamental para que dLocal acelerara sus ambiciones de IA y analítica.
La siguiente etapa requería algo más que nuevas herramientas: requería un modelo operativo distinto para producir, gobernar y consumir datos.
La visión: datos como producto, consumidos en lenguaje natural
Junto con Muttdata, dLocal diseñó y construyó dMesh, una plataforma de datos de autoservicio, totalmente gobernada y preparada para IA, basada en una arquitectura data mesh sobre Databricks. Pero dMesh no es solo una migración tecnológica: representa un cambio de fondo en cómo se producen, gobiernan y consumen los datos en toda la organización.
El principio central del nuevo modelo operativo es simple pero poderoso: tratar los datos como un producto. Cada conjunto de datos debe ser fácil de encontrar, confiable, autodescriptivo y estar diseñado para un consumo consistente.
Gobernanza federada: la responsabilidad donde está el conocimiento
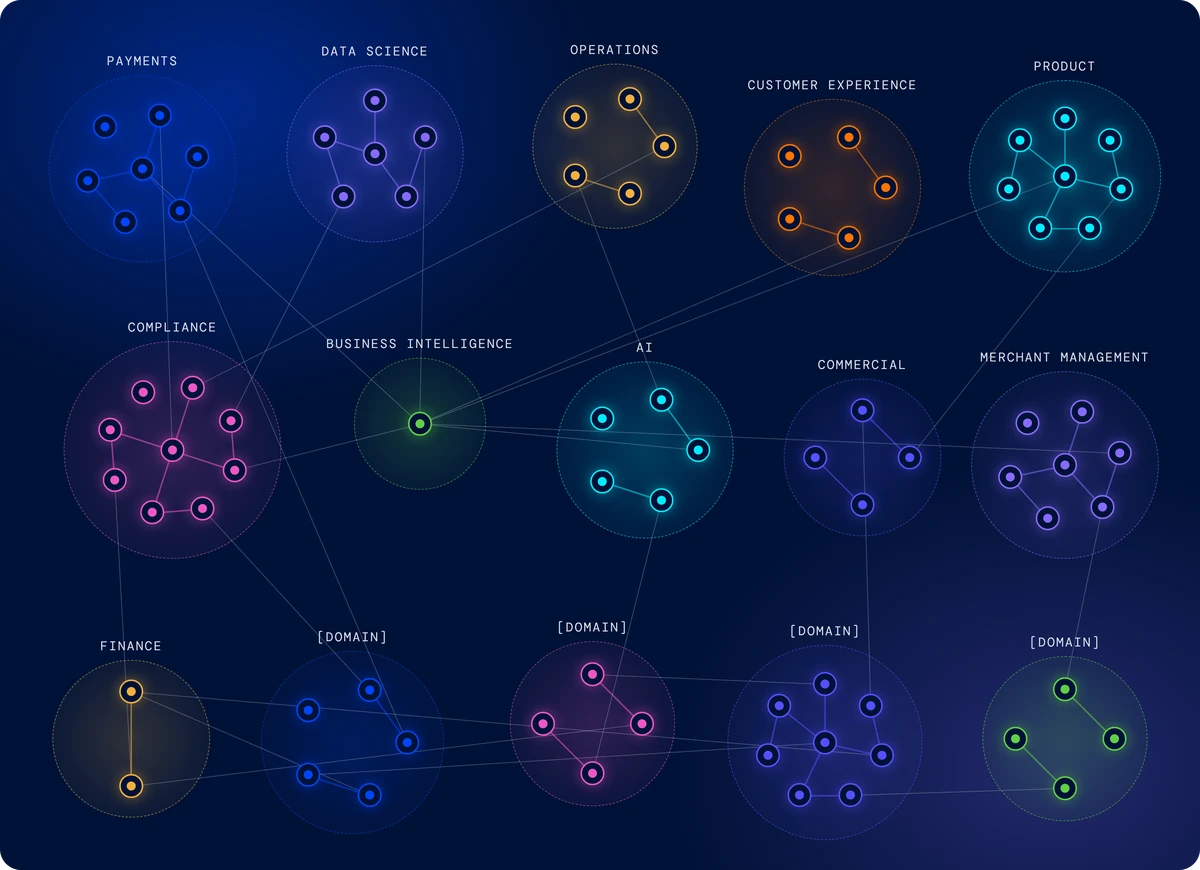
dMesh implementa un modelo de gobernanza federada que traslada la responsabilidad sobre los datos al lugar donde realmente está el conocimiento: los propios dominios de negocio. En lugar de canalizar cada decisión a través de un comité central, la gobernanza es computacional y está integrada desde el diseño.
Tres roles hacen que esto funcione en cada producto de datos:
- Data Owner: responsable general del producto de datos; se asegura de que resuelva problemas reales del negocio y mantenga su calidad. Suele ser un Head o VP del dominio.
- Business Data Steward: responsable de las definiciones del producto de datos, de supervisar el pipeline de entrega y del origen de los datos. Se asegura de que el significado del producto siga alineado con la realidad del negocio.
- Technical Data Steward: responsable de las implementaciones, los pipelines, los contratos y la respuesta ante incidentes. Mantiene el producto en funcionamiento y en evolución.
La gobernanza no es una barrera, sino que está integrada en la plataforma:
- Unity Catalog ofrece control de acceso centralizado, linaje y auditoría para todos los productos de datos.
- Cada activo se etiqueta automáticamente para atribuir costos y uso por dominio.
- La clasificación de datos PII/PCI, el hashing, el enmascaramiento y las políticas de acceso se aplican automáticamente a través del contrato de datos.
- Los controles de seguridad se aplican a nivel de plataforma, y el cumplimiento normativo es continuo, auditable y no frena a los equipos.
Un Grupo de Trabajo de Data Stewards se reúne mensualmente para monitorear y resolver problemas entre dominios, mientras que un Consejo de Gobernanza de Datos da la aprobación trimestral y resuelve conflictos. Pero la gobernanza del día a día ocurre automáticamente a través de la plataforma, sin necesidad de controles manuales.
dRiven: el programa de cambio cultural que hace que la tecnología perdure
Construir una plataforma de datos de autoservicio es solo la mitad del desafío. La otra mitad, más difícil y la que la mayoría de las implementaciones de data mesh descuidan, es cambiar cómo las personas piensan los datos en su trabajo diario. dLocal lo entendió desde el principio y lanzó dRiven junto con dMesh como un programa de cambio cultural deliberado y estructurado.
dRiven no es un curso sobre herramientas. Es una iniciativa de cambio de comportamiento diseñada para desarrollar tres capacidades centrales en toda la organización: curiosidad (cómo hacer mejores preguntas), pensamiento crítico (cómo poner a prueba supuestos y cuestionar las cifras principales) y creatividad (cómo mirar los datos desde más de un ángulo antes de tomar una decisión).
Por qué el cambio cultural importa tanto como la plataforma
La plataforma de datos más sofisticada del mundo no aporta ningún valor si nadie la usa, o peor aún, si se usa sin las habilidades para interpretar lo que se encuentra. El liderazgo de dLocal entendió que lograr decisiones basadas en datos de forma consistente y a escala requería más que acceso a mejores datos. Requería escalar los hábitos, la confianza y las expectativas que hacen que esas decisiones sean consistentes en cada equipo.
Como dijo el CEO de dLocal en el lanzamiento: “Todos hemos visto demasiadas versiones del mismo número que no podemos conciliar. Hemos pasado demasiado tiempo verificando los datos dos y tres veces, en lugar de usar ese tiempo para tomar las decisiones correctas. Toda buena decisión empieza con una pregunta que alguien tuvo la curiosidad de hacer”.
Cómo funciona dRiven en la práctica
El programa se estructura en cuatro módulos de aprendizaje progresivos, entregados en contenidos breves a través de una plataforma de microlearning, que van desde la conciencia básica hasta el pensamiento analítico aplicado:
- Analytics Savvy: una introducción ligera a los comportamientos de datos para toda la organización, que construye conciencia estratégica sin abrumar al personal no técnico.
- Data Accountable: contenido más profundo sobre propiedad de los datos, responsabilidades de gobernanza y el “ciclo de retroalimentación infinito” entre consumidores y productores de datos.
- Analytics Powered: habilidades prácticas para usar productos de datos y analítica impulsada por IA en la toma de decisiones cotidiana.
- Data Curious: técnicas avanzadas de formulación de preguntas, reconocimiento de sesgos y enfoques creativos para explorar los datos.
Un punto clave: el plan de estudios se enfoca en habilidades de comportamiento atemporales y no en capacitación sobre herramientas específicas. Las herramientas cambian; la capacidad de hacer una pregunta precisa, cuestionar un supuesto y pensar críticamente sobre lo que dicen los datos, no.
Un despliegue por fases con ciclos de retroalimentación integrados
dRiven arrancó con una cohorte piloto de aproximadamente 100 personas, entre data stewards, referentes de dominio y embajadores culturales, que probaron cada módulo, dieron feedback estructurado y ayudaron a ajustar el contenido antes del lanzamiento a toda la compañía. Este enfoque permitió que el programa se basara en el contexto real de la organización y no en una teoría genérica de alfabetización en datos.
El lanzamiento general se coordinó por múltiples canales: comunicaciones respaldadas por el CEO, “Launch Labs” presenciales en las oficinas con demos en vivo, un canal de comunidad dedicado al intercambio entre pares y un refuerzo progresivo del liderazgo mediante mensajes en video del CFO, el CTO, el COO y el CRO, cada uno conectando las capacidades de datos con las prioridades estratégicas de su área.
El liderazgo como ejemplo: un multiplicador de impacto
Un rasgo distintivo de dRiven es el peso que le da al liderazgo como principal motor del cambio cultural. En lugar de tratar la alfabetización en datos como un ejercicio de capacitación de abajo hacia arriba, el programa sumó explícitamente a los líderes sénior para que dieran el ejemplo con comportamientos basados en datos, respaldaran públicamente la iniciativa y la conectaran con los objetivos estratégicos de sus equipos.
Cada líder del C-suite grabó un mensaje personal explicando por qué las capacidades de datos importan para su función, no en términos abstractos, sino vinculadas a resultados de negocio concretos: mejores pronósticos y asignación de capital (CFO), diagnóstico y priorización más rápidos (CTO), detección temprana de problemas y ejecución consistente (COO), y decisiones comerciales más certeras y crecimiento (CRO).
Medir el cambio cultural, no solo las tasas de finalización
dRiven mide más que los cursos completados. El programa evalúa la profundidad del compromiso:
- Cuántas personas hacen preguntas activamente en la plataforma
- Cuántas comparten hallazgos con sus pares
- Cuántas aplican hábitos de datos en sus flujos de trabajo
Solo el día del lanzamiento, 106 nuevos usuarios accedieron a la plataforma, 96 ejecutaron su primera consulta, 40 se sumaron de forma orgánica al canal de comunidad y 9 compartieron sus resultados públicamente, todo sin que fuera obligatorio.
La estrategia de comunicación del programa avanza deliberadamente desde la difusión del lanzamiento hacia la relevancia práctica y, de ahí, hacia una adopción impulsada por la comunidad, con controles periódicos que indican si hace falta una intervención adicional. El objetivo no es crear un evento de capacitación aislado, sino incorporar la toma de decisiones basada en datos como un hábito organizacional consistente a medida que dLocal crece.
Los resultados: 80 productos de datos certificados en 3 meses
El impacto de dMesh fue medible y rápido:
- 80 productos de datos certificados activos en 15 dominios de negocio, que abarcan pagos, compliance, gestión de comercios, operaciones, comercial, experiencia del cliente, ciencia de datos y más.
- 680 usuarios activos consumiendo productos de datos certificados en el último mes, con más de 100 nuevos usuarios el día del lanzamiento que generaron casi 38.000 eventos de acceso a datos.
Los productos de datos más consumidos reflejan el valor real para el negocio: los productos de datos transaccionales principales superaron los 300 usuarios únicos cada uno en el primer mes, seguidos de cerca por los productos de datos de comercios y operaciones. Hoy los usan a diario cientos de personas en toda la organización, desde account managers hasta ingenieros de producto y analistas de compliance.
Qué significa esto para la industria
dMesh demuestra que la visión del data mesh, a menudo criticada por teórica o poco práctica, puede implementarse a escala cuando cuenta con la plataforma adecuada, la disciplina de ingeniería correcta y el partner indicado.
Las lecciones clave del recorrido de dLocal:
- El consumo de autoservicio mediante IA es real. No es una demo, sino una capacidad en producción que atiende a cientos de usuarios todos los días. Las interfaces en lenguaje natural sobre capas semánticas gobernadas eliminan la barrera del SQL sin sacrificar confianza.
- La producción se puede democratizar. Cuando los equipos de dominio cuentan con herramientas basadas en código, con plantillas y gobernanza integrada, pueden producir productos de datos certificados sin conocimientos profundos de ingeniería de plataformas.
- La disciplina de ingeniería no es negociable. Los contratos de datos como código, el CI/CD para productos de datos y el control de calidad automatizado son lo que distingue un data mesh que funciona de un conjunto de tablas sin gobernanza.
- La gobernanza federada funciona cuando es computacional. La propiedad, la custodia y el cumplimiento normativo se integran en la plataforma desde el diseño, no se imponen mediante comités y documentos de políticas.
- La adopción sigue al valor. El crecimiento exponencial de usuarios de dMesh se debió a que encontrar, confiar y usar los datos se volvió realmente más fácil, no a que la adopción fuera obligatoria.
- El cambio cultural no es opcional. La tecnología por sí sola no cambia comportamientos. Un programa deliberado que desarrolle curiosidad, pensamiento crítico y confianza en los datos, respaldado por el CEO y el C-suite, es lo que convierte el lanzamiento de una plataforma en un hábito organizacional.
Menos barreras para la producción de autoservicio gracias a la IA
dMesh no solo facilita el consumo: también democratizó la producción de datos mediante herramientas asistidas por IA y buenas prácticas de ingeniería.
Los equipos de dominio, que son quienes realmente entienden los datos, hoy pueden producir productos de datos certificados con:
- AI Skills para construir la primera versión de un nuevo producto de datos, contrastándola con los productos de datos existentes.
- Una Data Product Factory con herramientas CLI basadas en plantillas, para que crear un nuevo producto de datos siga un proceso guiado y repetible, en lugar de ser un proyecto de ingeniería a medida.
Un integrante de un equipo de dominio inicia un nuevo producto de datos con un solo comando CLI, completa un contrato de datos en YAML que define el esquema, las fuentes de entrada, los SLA, la clasificación de los datos y sus responsables, y la plataforma se encarga del resto: gobernanza, etiquetado, políticas de acceso y despliegue.
La IA reduce aún más la barrera. La plataforma usa IA para asistir con la lógica de transformación, la generación de reglas de calidad y el enriquecimiento de metadatos, lo que permite que los equipos de dominio se concentren en la lógica de negocio y no en la infraestructura.
A través de Databricks Genie, integrado con herramientas de IA conversacional como Glean y Claude, cualquier colaborador de dLocal puede hacer preguntas en lenguaje natural y obtener respuestas confiables y gobernadas en segundos. Un Technical Account Manager puede preguntar “¿Qué comercios de Brasil todavía no adoptaron Pix?” y detectar al instante oportunidades de venta cruzada. Un product manager puede validar resultados de pruebas A/B sin abrir un pedido de datos. Un analista de finanzas puede obtener datos de conciliación sin esperar al equipo central.
No se trata de un chatbot agregado encima de una base de datos. La capa conversacional se apoya en una capa semántica y en metric views gobernadas, lo que garantiza que cuando alguien pregunta por la “tasa de conversión” o el “TPV”, obtenga la misma definición certificada en toda la organización.
El resultado: el tiempo entre una pregunta y una respuesta confiable se mide en minutos, no en días ni semanas.
Todo definido como código: buenas prácticas de ingeniería en el centro
Lo que hace a dMesh realmente distinto de muchas implementaciones de data mesh es su compromiso innegociable con la disciplina de ingeniería. Cada producto de datos se define, prueba y publica con los mismos estándares que el software de cara al cliente:
- Contratos de datos como código (YAML): cada producto de datos tiene un contrato legible por máquina que define su esquema, responsables, clasificación de sensibilidad, reglas de retención y SLA. Estos contratos se versionan en Git junto con la lógica de transformación.
- Asset Bundles para despliegues repetibles: los productos de datos se empaquetan como Databricks Asset Bundles, artefactos versionados y testeables que pueden promoverse entre los entornos dev → test → prod con pipelines completos de CI/CD.
- Control de calidad automatizado: los checks de contrato de Soda se ejecutan automáticamente y sus resultados alimentan un Data Quality Monitoring Dashboard centralizado. Cada producto se valida de forma continua en frescura, completitud y cumplimiento del esquema.
- Infraestructura como código: toda la plataforma (catálogos, esquemas, políticas, service principals y controles de acceso) se gestiona mediante código, no con configuración manual.
Este enfoque implica que un producto de datos creado por un equipo de pagos sigue exactamente los mismos estándares, gobernanza y proceso de despliegue que uno creado por compliance o experiencia del cliente. La consistencia está integrada en el sistema, no impuesta a través de documentos de procesos.
Sobre el partnership
Muttdata trabajó junto a dLocal para diseñar la arquitectura de dMesh, implementar la Data Product Factory, establecer el modelo de gobernanza federada, acelerar la incorporación de dominios y co-desarrollar el programa de cambio cultural dRiven. El proyecto combinó un profundo conocimiento de la plataforma Databricks con experiencia práctica en gestión del cambio organizacional, porque construir un data mesh es tanto una transformación cultural como técnica.
Juntos, dMesh y dRiven son mucho más que tecnología: fortalecen la base de datos que sostiene la inteligencia de dLocal y le dan a cada equipo datos confiables y la seguridad para actuar en función de ellos a medida que la compañía escala en mercados emergentes. Y los resultados hablan por sí solos.
¿Quieres saber cómo Muttdata puede ayudar a tu organización a construir un data mesh listo para producción? Contáctanos
